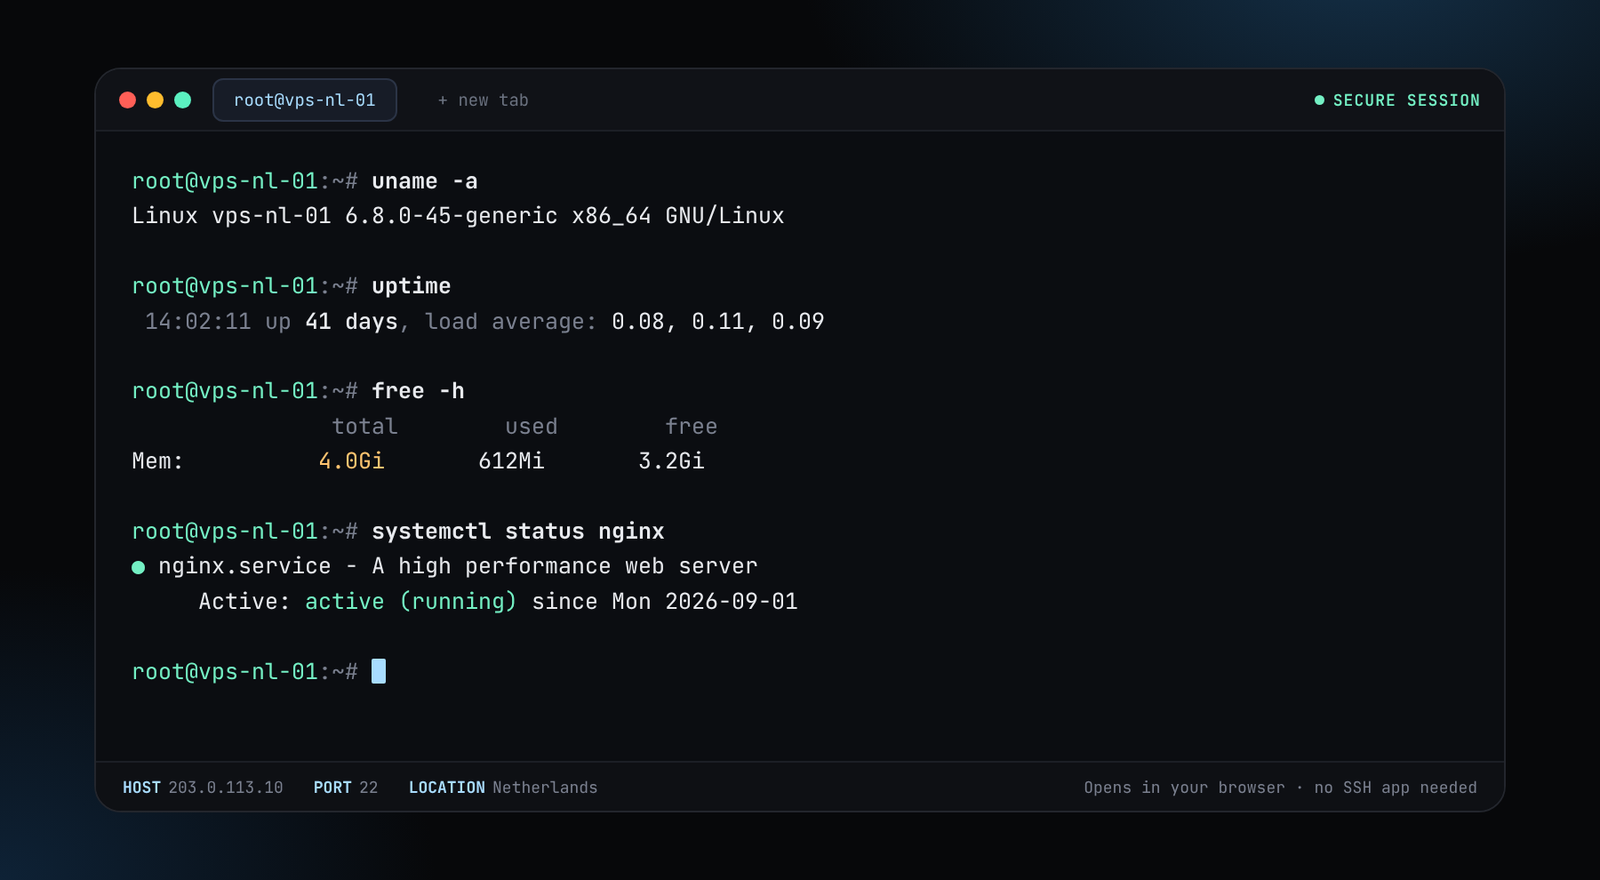
Temos uma novidade. Agora oferecemos nosso próprio console web. Abra o console e digite ssh root@your-server-ip para acessar qualquer servidor seu direto do navegador. Não é preciso um app de SSH.
Agentes e automações precisam de uma máquina sempre ligada, com IP próprio, que não dorme quando seu notebook dorme. Comece em um VPS a partir de $8.50 por mês para frameworks de agentes que chamam modelos hospedados, ou passe para um servidor GPU a partir de $109.25 por mês para rodar o modelo você mesmo. Root completo, armazenamento NVMe, pagamento em cripto.


Os preços de VPS são da Romênia em um prazo de um mês. Um prazo de 12 meses dá 50% de desconto. Os preços de GPU são da Moldávia.
or $4.25/mo on a 12-month term (−50%)
Um ou dois agentes ou fluxos que chamam APIs de modelos hospedados, mais um banco de dados pequeno.
Configure and orderor $6.50/mo on a 12-month term (−50%)
n8n ou um framework com Postgres, um armazenamento de vetores e um navegador headless para tarefas na web.
Configure and orderor $12.75/mo on a 12-month term (−50%)
Pequenos modelos quantizados na CPU, lentos mas privados, ao lado dos seus agentes.
Configure and orderor $54.63/mo on a 12-month term (−50%)
Rode um modelo no mesmo servidor do agente que o usa. GPUs maiores estão na página de GPU.
Configure and ordern8n e ferramentas semelhantes: webhooks, agendamentos e integrações que rodam esteja você online ou não.
LangGraph, CrewAI, AutoGen ou seu próprio código em Python e Node, iniciado pelo systemd e reiniciado se falhar.
Chromium headless com Playwright para scraping, monitoramento e preenchimento de formulários. Dê a ele 8 GB de RAM.
Ollama ou vLLM servindo um modelo aberto, para que prompts e documentos fiquem em um servidor que você aluga.
Ferramentas que seu assistente pode chamar. Veja a hospedagem de servidores MCP para os detalhes.
Bots de Telegram e Discord, bots de trading e tarefas cron que precisam rodar o dia todo.
A maioria dos agentes faz muito pouco trabalho por conta própria. Eles enviam um prompt a um modelo, esperam e depois chamam uma ferramenta. Se o modelo roda em um provedor, o servidor do agente só precisa de alguns gigabytes de RAM e uma conexão estável, então o VPS inicial basta.
Um agente pode executar código e chamar ferramentas, então trate-o como qualquer processo não confiável. Dê a ele seu próprio usuário Linux ou contêiner, uma chave de API do modelo com limite de gastos e apenas o acesso a arquivos e à rede de que precisa. Nunca coloque a chave de gastos de uma carteira nem uma senha de administrador no ambiente de um agente.
Crie uma conta, recarregue com cripto e implante o tamanho que escolheu. Você recebe acesso root em poucos minutos.
Atualize o Ubuntu, crie um usuário, abra apenas as portas necessárias e instale o Docker.
Inicie o n8n com Docker Compose ou rode seu próprio agente em Python como serviço systemd.
Coloque o Caddy na frente para HTTPS e instale o Ollama em um servidor GPU.
Os comandos assumem Ubuntu 22.04 ou 24.04 e um login root por SSH.
ssh root@YOUR_SERVER_IP

apt update && apt -y upgrade
adduser --disabled-password --gecos "" agent

ufw allow OpenSSH
ufw allow 80/tcp
ufw allow 443/tcp
ufw enablecurl -fsSL https://get.docker.com | sh
usermod -aG docker agent
systemctl enable --now dockerAqui o n8n escuta apenas em localhost. O Caddy (passo 3) adiciona HTTPS na frente. Troque agents.example.com por um domínio que aponte para o seu servidor. Veja a documentação de hospedagem do n8n para as opções atuais.
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n
    restart: unless-stopped
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_HOST=agents.example.com
      - N8N_PROTOCOL=https
      - WEBHOOK_URL=https://agents.example.com/
      - GENERIC_TIMEZONE=UTC
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
n8n_data:su - agent
cd ~/n8n
docker compose up -d
docker compose logs -f # Ctrl+C to stop watchingUma unidade systemd inicia o agente no boot e o reinicia se travar. Os segredos ficam em um arquivo que só o usuário do agente pode ler.
su - agent
mkdir -p ~/app && cd ~/app
python3 -m venv venv
./venv/bin/pip install requests      # add your framework: langgraph, crewai, autogen...
nano agent.py                       # your agent code
nano .env                           # API_KEY=...   (then: chmod 600 .env)
exit[Unit]
Description=My AI agent
After=network-online.target
Wants=network-online.target
[Service]
User=agent
WorkingDirectory=/home/agent/app
EnvironmentFile=/home/agent/app/.env
ExecStart=/home/agent/app/venv/bin/python agent.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetsystemctl daemon-reload
systemctl enable --now agent
journalctl -u agent -f # Ctrl+C to stop watchingO Caddy obtém e renova um certificado sozinho assim que seu domínio aponta para o servidor. Webhooks e interfaces web passam a funcionar por HTTPS.
apt -y install caddy
cat > /etc/caddy/Caddyfile <<'EOF'
agents.example.com {
    reverse_proxy 127.0.0.1:5678
}
EOF
systemctl reload caddyO Ollama serve um modelo em localhost, e seu agente o chama em vez de uma API hospedada. Escolha um modelo que caiba na memória da GPU (veja a tabela de dimensionamento).
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Say hello in five words.",
  "stream": false
}'# Ollama listens on 127.0.0.1:11434 by default. Leave it that way.
# If an agent on another server needs it, tunnel over SSH instead of opening the port:
ssh -N -L 11434:127.0.0.1:11434 agent@YOUR_SERVER_IPUm servidor que executa seus agentes de IA, automações e bots o tempo todo. Você aluga um VPS ou servidor GPU com acesso root, instala o software dos agentes e deixa rodando.
Qualquer coisa que rode em Linux: n8n, LangGraph, CrewAI, AutoGen, Flowise, Open WebUI, seu próprio código em Python ou Node e servidores MCP. Você tem root completo, então o Docker também funciona.
Só para rodar o modelo você mesmo. Se seus agentes chamam uma API de modelo hospedado, um VPS basta. Um servidor GPU faz sentido para modelos abertos locais como Llama, Mistral ou Qwen, ou quando os prompts não podem sair do seu servidor.
4 GB para um framework que chama modelos hospedados, 8 GB com banco de dados ou navegador headless e 32 GB ou uma GPU para modelos locais. Você pode migrar para um plano maior depois.
Sim. O Chromium headless com Playwright funciona em um VPS. Planeje cerca de 500 MB a 1 GB de RAM por página aberta e dê 8 GB ao servidor se vários rodarem ao mesmo tempo.
Não. Você cria uma conta com um login gerado, recarrega com cripto e implanta. Veja a hospedagem VPS sem KYC. Você continua responsável pelo que seus agentes fazem, conforme nossos termos.
Pelo saldo da sua conta, recarregado com Bitcoin, Monero, Ethereum, Litecoin, Solana, TRON, BNB, USDC ou USDT. Prazos mais longos dão até 50% de desconto. Veja os preços.
Checked 20 October 2026. Chain sizes and software requirements change, so confirm against the source before you order.
Escolha um tamanho, pague em cripto, entre como root. Sem documento, sem cartão.