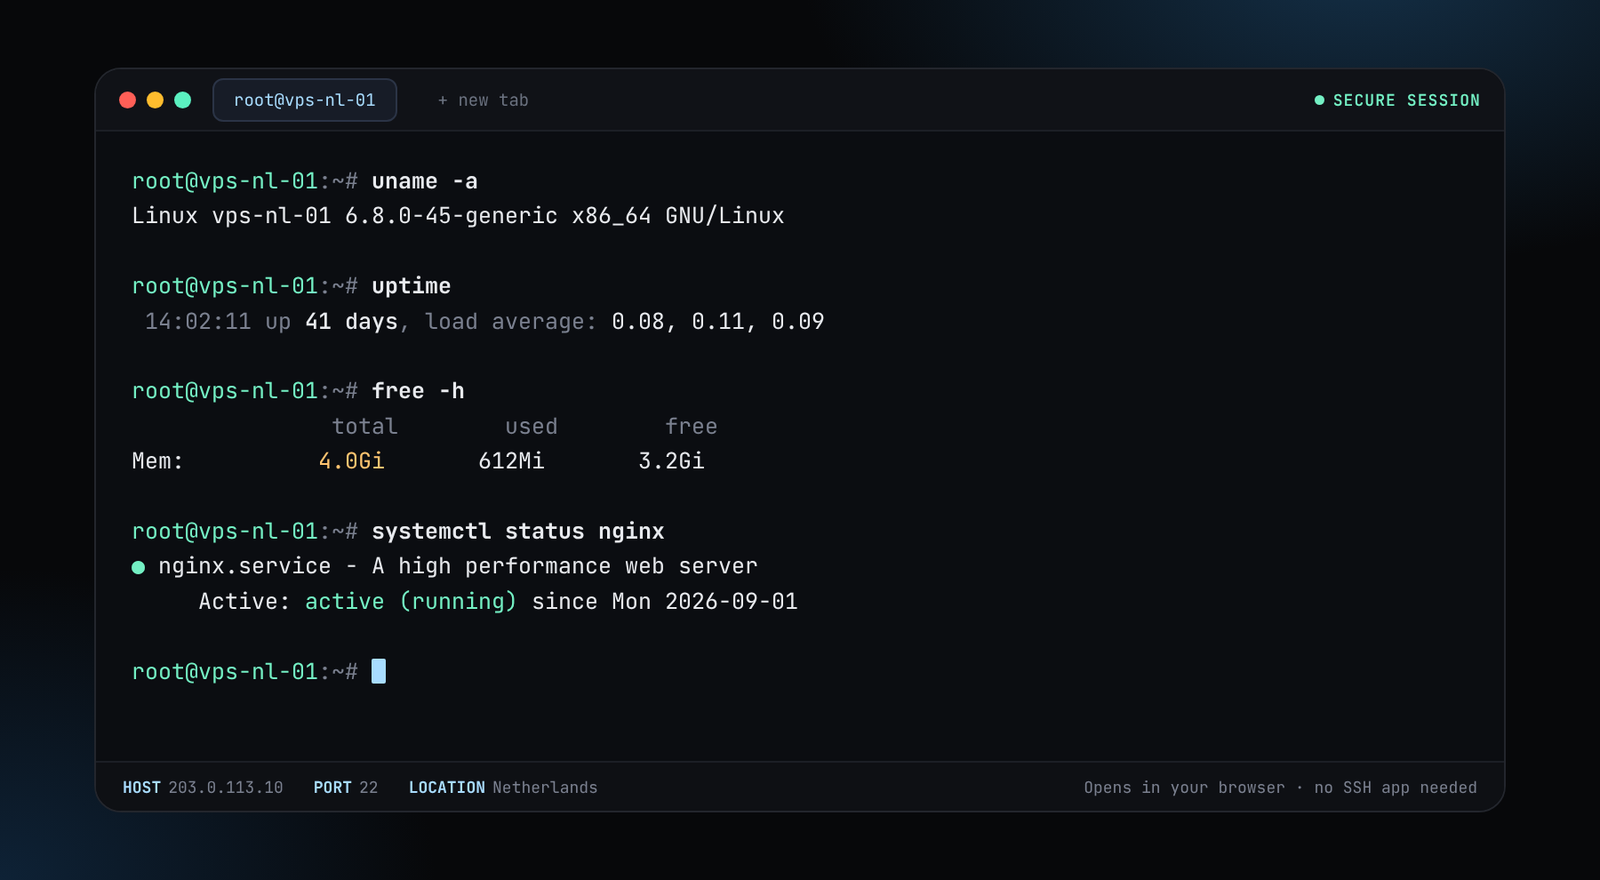
Wir haben ein neues Update. Ab sofort bieten wir unsere eigene Web-Konsole. Öffne die Konsole und gib ssh root@your-server-ip ein, um jeden deiner Server direkt im Browser zu erreichen. Keine SSH-App nötig.
Agenten und Automatisierungen brauchen eine Maschine, die immer läuft, eine eigene IP hat und nicht schlafen geht, wenn dein Laptop es tut. Starte auf einem VPS ab $8.50 im Monat für Agenten-Frameworks, die gehostete Modelle aufrufen, oder wechsle auf einen GPU-Server ab $109.25 im Monat, um das Modell selbst zu betreiben. Voller Root-Zugriff, NVMe-Speicher, Zahlung in Krypto.


VPS-Preise gelten für Rumänien bei einer Laufzeit von einem Monat. Eine 12-Monats-Laufzeit spart 50 %. GPU-Preise gelten für Moldau.
or $4.25/mo on a 12-month term (−50%)
Ein oder zwei Agenten oder Workflows, die gehostete Modell-APIs aufrufen, plus eine kleine Datenbank.
Configure and orderor $6.50/mo on a 12-month term (−50%)
n8n oder ein Framework mit Postgres, einem Vektorspeicher und einem Headless-Browser für Web-Aufgaben.
Configure and orderor $12.75/mo on a 12-month term (−50%)
Kleine quantisierte Modelle auf der CPU, langsam, aber privat, direkt neben deinen Agenten.
Configure and orderor $54.63/mo on a 12-month term (−50%)
Betreibe ein Modell auf demselben Server wie den Agenten, der es nutzt. Größere GPUs findest du auf der GPU-Seite.
Configure and ordern8n und ähnliche Tools: Webhooks, Zeitpläne und Integrationen, die laufen, egal ob du online bist.
LangGraph, CrewAI, AutoGen oder dein eigener Python- und Node-Code, per systemd gestartet und bei Fehlern neu gestartet.
Headless Chromium mit Playwright für Scraping, Monitoring und das Ausfüllen von Formularen. Gib ihm 8 GB RAM.
Ollama oder vLLM stellt ein offenes Modell bereit, sodass Prompts und Dokumente auf einem Server bleiben, den du mietest.
Tools, die dein Assistent aufrufen kann. Details findest du unter MCP-Server-Hosting.
Telegram- und Discord-Bots, Trading-Bots und Cronjobs, die den ganzen Tag laufen müssen.
Die meisten Agenten leisten selbst sehr wenig Arbeit. Sie senden einen Prompt an ein Modell, warten und rufen dann ein Tool auf. Läuft das Modell bei einem Anbieter, braucht der Agent-Server nur ein paar Gigabyte RAM und eine stabile Verbindung, sodass der Starter-VPS reicht.
Ein Agent kann Code ausführen und Tools aufrufen, behandle ihn also wie jeden nicht vertrauenswürdigen Prozess. Gib ihm einen eigenen Linux-Benutzer oder Container, einen Modell-API-Schlüssel mit Ausgabenlimit und nur den Datei- und Netzwerkzugriff, den er braucht. Lege niemals den Ausgabeschlüssel eines Wallets oder ein Admin-Passwort in die Umgebung eines Agenten.
Konto erstellen, mit Krypto aufladen und die gewählte Größe bereitstellen. Du erhältst Root-Zugriff innerhalb weniger Minuten.
Ubuntu aktualisieren, einen Benutzer anlegen, nur die nötigen Ports öffnen und Docker installieren.
Starte n8n mit Docker Compose oder betreibe deinen eigenen Python-Agenten als systemd-Dienst.
Setze Caddy für HTTPS davor und installiere Ollama auf einem GPU-Server.
Die Befehle setzen Ubuntu 22.04 oder 24.04 und ein Root-Login per SSH voraus.
ssh root@YOUR_SERVER_IP

apt update && apt -y upgrade
adduser --disabled-password --gecos "" agent

ufw allow OpenSSH
ufw allow 80/tcp
ufw allow 443/tcp
ufw enablecurl -fsSL https://get.docker.com | sh
usermod -aG docker agent
systemctl enable --now dockern8n lauscht hier nur auf localhost. Caddy (Schritt 3) setzt HTTPS davor. Ersetze agents.example.com durch eine Domain, die auf deinen Server zeigt. Aktuelle Optionen findest du in der n8n-Hosting-Dokumentation.
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n
    restart: unless-stopped
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_HOST=agents.example.com
      - N8N_PROTOCOL=https
      - WEBHOOK_URL=https://agents.example.com/
      - GENERIC_TIMEZONE=UTC
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
n8n_data:su - agent
cd ~/n8n
docker compose up -d
docker compose logs -f # Ctrl+C to stop watchingEine systemd-Unit startet den Agenten beim Booten und startet ihn nach einem Absturz neu. Geheimnisse liegen in einer Datei, die nur der Agent-Benutzer lesen kann.
su - agent
mkdir -p ~/app && cd ~/app
python3 -m venv venv
./venv/bin/pip install requests      # add your framework: langgraph, crewai, autogen...
nano agent.py                       # your agent code
nano .env                           # API_KEY=...   (then: chmod 600 .env)
exit[Unit]
Description=My AI agent
After=network-online.target
Wants=network-online.target
[Service]
User=agent
WorkingDirectory=/home/agent/app
EnvironmentFile=/home/agent/app/.env
ExecStart=/home/agent/app/venv/bin/python agent.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetsystemctl daemon-reload
systemctl enable --now agent
journalctl -u agent -f # Ctrl+C to stop watchingCaddy bezieht und erneuert ein Zertifikat selbstständig, sobald deine Domain auf den Server zeigt. Webhooks und Weboberflächen funktionieren dann über HTTPS.
apt -y install caddy
cat > /etc/caddy/Caddyfile <<'EOF'
agents.example.com {
    reverse_proxy 127.0.0.1:5678
}
EOF
systemctl reload caddyOllama stellt ein Modell auf localhost bereit, und dein Agent ruft es statt einer gehosteten API auf. Wähle ein Modell, das in den GPU-Speicher passt (siehe Größentabelle).
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Say hello in five words.",
  "stream": false
}'# Ollama listens on 127.0.0.1:11434 by default. Leave it that way.
# If an agent on another server needs it, tunnel over SSH instead of opening the port:
ssh -N -L 11434:127.0.0.1:11434 agent@YOUR_SERVER_IPEin Server, auf dem deine KI-Agenten, Automatisierungen und Bots rund um die Uhr laufen. Du mietest einen VPS oder GPU-Server mit Root-Zugriff, installierst deine Agent-Software und lässt sie laufen.
Alles, was unter Linux läuft: n8n, LangGraph, CrewAI, AutoGen, Flowise, Open WebUI, dein eigener Python- oder Node-Code und MCP-Server. Du hast vollen Root-Zugriff, daher funktioniert auch Docker.
Nur, wenn du das Modell selbst betreibst. Rufen deine Agenten eine gehostete Modell-API auf, genügt ein VPS. Ein GPU-Server lohnt sich für lokale offene Modelle wie Llama, Mistral oder Qwen oder wenn Prompts deinen Server nicht verlassen dürfen.
4 GB für ein Framework, das gehostete Modelle aufruft, 8 GB mit Datenbank oder Headless-Browser und 32 GB oder eine GPU für lokale Modelle. Du kannst später auf einen größeren Plan wechseln.
Ja. Headless Chromium mit Playwright läuft auf einem VPS. Plane etwa 500 MB bis 1 GB RAM pro geöffneter Seite ein und gib dem Server 8 GB, wenn mehrere gleichzeitig laufen.
Nein. Du erstellst ein Konto mit einem generierten Login, lädst mit Krypto auf und stellst bereit. Siehe VPS-Hosting ohne KYC. Für das, was deine Agenten tun, bleibst du nach unseren Bedingungen verantwortlich.
Vom Guthaben deines Kontos, aufgeladen mit Bitcoin, Monero, Ethereum, Litecoin, Solana, TRON, BNB, USDC oder USDT. Längere Laufzeiten sparen bis zu 50 %. Siehe Preise.
Checked 20 October 2026. Chain sizes and software requirements change, so confirm against the source before you order.
Wähle eine Größe, zahle in Krypto, melde dich als root an. Ohne ID, ohne Karte.