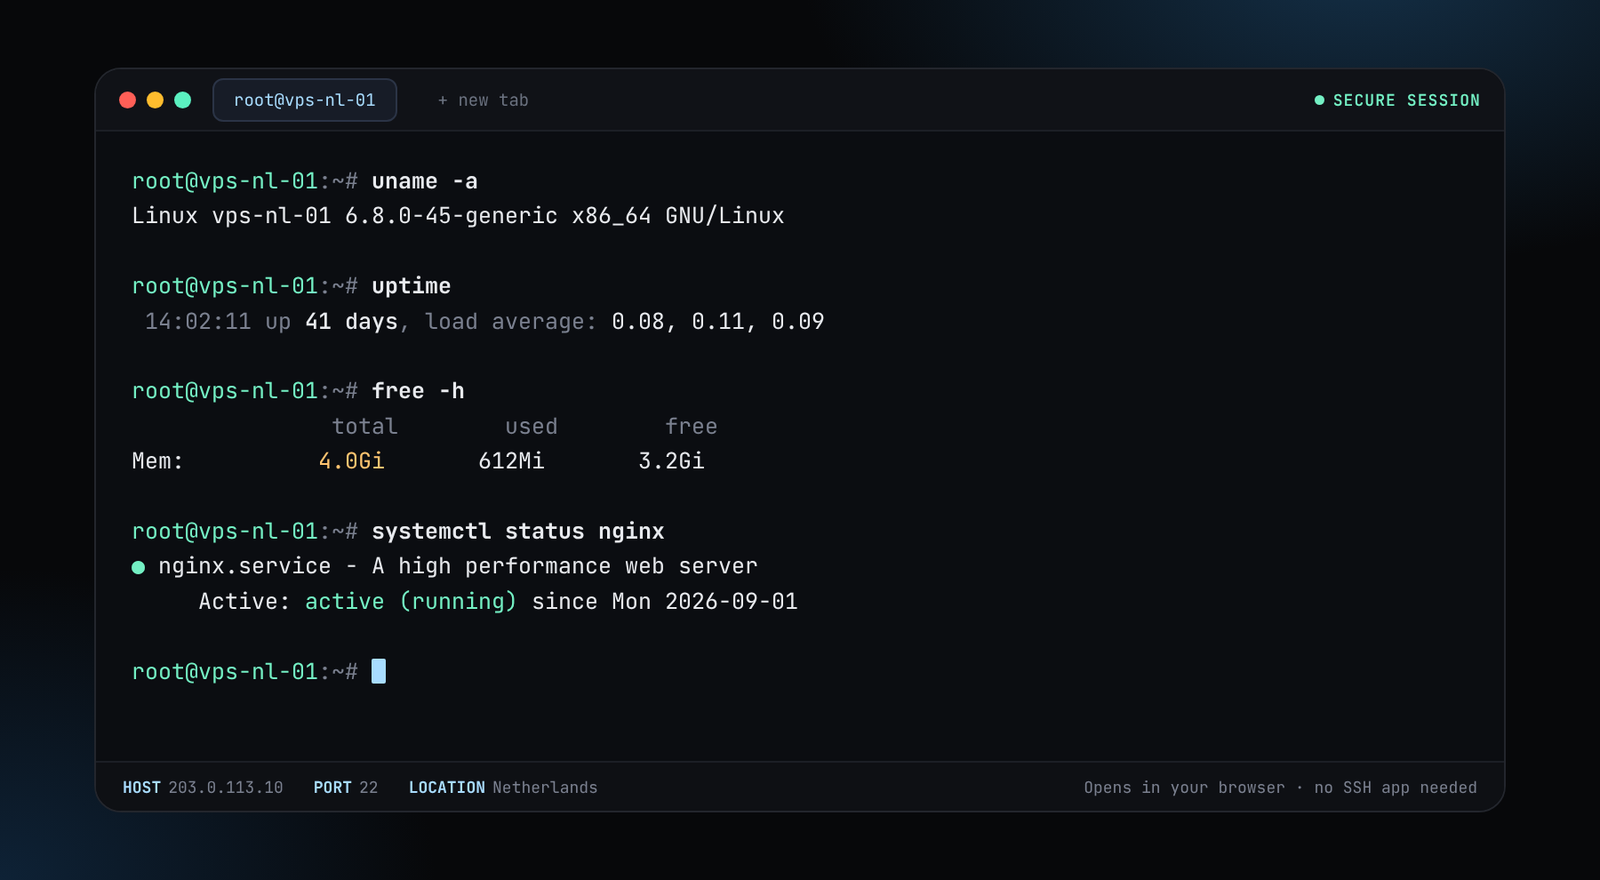
Nous avons une nouveauté. Nous proposons désormais notre propre console web. Ouvrez la console et saisissez ssh root@your-server-ip pour accéder à n’importe lequel de vos serveurs, directement depuis votre navigateur. Aucune application SSH n’est nécessaire.
Les agents et les automatisations ont besoin d’une machine toujours allumée, avec sa propre IP, qui ne s’endort pas quand votre ordinateur portable le fait. Commencez sur un VPS à partir de $8.50 par mois pour des frameworks d’agents qui appellent des modèles hébergés, ou passez à un serveur GPU à partir de $109.25 par mois pour exécuter le modèle vous-même. Root complet, stockage NVMe, paiement en crypto.


Les prix des VPS correspondent à la Roumanie pour une durée d’un mois. Une durée de 12 mois fait économiser 50 %. Les prix des GPU correspondent à la Moldavie.
or $4.25/mo on a 12-month term (−50%)
Un ou deux agents ou workflows qui appellent des API de modèles hébergés, plus une petite base de données.
Configure and orderor $6.50/mo on a 12-month term (−50%)
n8n ou un framework avec Postgres, un magasin de vecteurs et un navigateur headless pour les tâches web.
Configure and orderor $12.75/mo on a 12-month term (−50%)
De petits modèles quantifiés sur CPU, lents mais privés, à côté de vos agents.
Configure and orderor $54.63/mo on a 12-month term (−50%)
Exécutez un modèle sur le même serveur que l’agent qui l’utilise. Des GPU plus puissants sont sur la page GPU.
Configure and ordern8n et outils similaires : webhooks, planifications et intégrations qui tournent que vous soyez en ligne ou non.
LangGraph, CrewAI, AutoGen ou votre propre code Python et Node, lancé par systemd et relancé en cas d’échec.
Chromium headless avec Playwright pour le scraping, la surveillance et le remplissage de formulaires. Donnez-lui 8 Go de RAM.
Ollama ou vLLM servant un modèle ouvert, pour que vos prompts et documents restent sur un serveur que vous louez.
Des outils que votre assistant peut appeler. Voir l’hébergement de serveurs MCP pour les détails.
Bots Telegram et Discord, bots de trading et tâches cron qui doivent tourner toute la journée.
La plupart des agents font très peu de travail eux-mêmes. Ils envoient un prompt à un modèle, attendent, puis appellent un outil. Si le modèle tourne chez un fournisseur, le serveur de l’agent n’a besoin que de quelques gigaoctets de RAM et d’une connexion stable : le VPS de départ suffit.
Un agent peut exécuter du code et appeler des outils : traitez-le comme n’importe quel processus non fiable. Donnez-lui son propre utilisateur Linux ou conteneur, une clé d’API de modèle avec un plafond de dépenses et seulement l’accès aux fichiers et au réseau dont il a besoin. Ne mettez jamais la clé de dépense d’un portefeuille ni un mot de passe administrateur dans l’environnement d’un agent.
Créez un compte, rechargez en crypto et déployez la taille choisie. Vous obtenez l’accès root en quelques minutes.
Mettez Ubuntu à jour, créez un utilisateur, n’ouvrez que les ports nécessaires et installez Docker.
Démarrez n8n avec Docker Compose, ou exécutez votre propre agent Python comme service systemd.
Placez Caddy devant pour le HTTPS et installez Ollama sur un serveur GPU.
Les commandes supposent Ubuntu 22.04 ou 24.04 et une connexion root par SSH.
ssh root@YOUR_SERVER_IP

apt update && apt -y upgrade
adduser --disabled-password --gecos "" agent

ufw allow OpenSSH
ufw allow 80/tcp
ufw allow 443/tcp
ufw enablecurl -fsSL https://get.docker.com | sh
usermod -aG docker agent
systemctl enable --now dockerIci, n8n n’écoute que sur localhost. Caddy (étape 3) ajoute le HTTPS devant. Remplacez agents.example.com par un domaine qui pointe vers votre serveur. Consultez la documentation d’hébergement de n8n pour les options actuelles.
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n
    restart: unless-stopped
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_HOST=agents.example.com
      - N8N_PROTOCOL=https
      - WEBHOOK_URL=https://agents.example.com/
      - GENERIC_TIMEZONE=UTC
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
n8n_data:su - agent
cd ~/n8n
docker compose up -d
docker compose logs -f # Ctrl+C to stop watchingUne unité systemd démarre l’agent au boot et le relance s’il plante. Les secrets se trouvent dans un fichier que seul l’utilisateur de l’agent peut lire.
su - agent
mkdir -p ~/app && cd ~/app
python3 -m venv venv
./venv/bin/pip install requests      # add your framework: langgraph, crewai, autogen...
nano agent.py                       # your agent code
nano .env                           # API_KEY=...   (then: chmod 600 .env)
exit[Unit]
Description=My AI agent
After=network-online.target
Wants=network-online.target
[Service]
User=agent
WorkingDirectory=/home/agent/app
EnvironmentFile=/home/agent/app/.env
ExecStart=/home/agent/app/venv/bin/python agent.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetsystemctl daemon-reload
systemctl enable --now agent
journalctl -u agent -f # Ctrl+C to stop watchingCaddy obtient et renouvelle un certificat tout seul dès que votre domaine pointe vers le serveur. Les webhooks et les interfaces web fonctionnent alors en HTTPS.
apt -y install caddy
cat > /etc/caddy/Caddyfile <<'EOF'
agents.example.com {
    reverse_proxy 127.0.0.1:5678
}
EOF
systemctl reload caddyOllama sert un modèle sur localhost, et votre agent l’appelle au lieu d’une API hébergée. Choisissez un modèle qui tient dans la mémoire du GPU (voir le tableau de dimensionnement).
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Say hello in five words.",
  "stream": false
}'# Ollama listens on 127.0.0.1:11434 by default. Leave it that way.
# If an agent on another server needs it, tunnel over SSH instead of opening the port:
ssh -N -L 11434:127.0.0.1:11434 agent@YOUR_SERVER_IPUn serveur qui exécute vos agents IA, automatisations et bots en continu. Vous louez un VPS ou un serveur GPU avec accès root, installez votre logiciel d’agents et le laissez tourner.
Tout ce qui tourne sous Linux : n8n, LangGraph, CrewAI, AutoGen, Flowise, Open WebUI, votre propre code Python ou Node et des serveurs MCP. Vous avez le root complet, donc Docker fonctionne aussi.
Seulement pour exécuter le modèle vous-même. Si vos agents appellent une API de modèle hébergé, un VPS suffit. Un serveur GPU a du sens pour des modèles ouverts locaux comme Llama, Mistral ou Qwen, ou lorsque les prompts ne doivent pas quitter votre serveur.
4 Go pour un framework qui appelle des modèles hébergés, 8 Go avec une base de données ou un navigateur headless, et 32 Go ou un GPU pour les modèles locaux. Vous pourrez passer à une offre plus grande plus tard.
Oui. Chromium headless avec Playwright fonctionne sur un VPS. Prévoyez environ 500 Mo à 1 Go de RAM par page ouverte et donnez 8 Go au serveur si plusieurs tournent en même temps.
Non. Vous créez un compte avec un identifiant généré, rechargez en crypto et déployez. Voir l’hébergement VPS sans KYC. Vous restez responsable de ce que font vos agents, selon nos conditions.
Depuis le solde de votre compte, rechargé en Bitcoin, Monero, Ethereum, Litecoin, Solana, TRON, BNB, USDC ou USDT. Les durées plus longues font économiser jusqu’à 50 %. Voir les tarifs.
Checked 20 October 2026. Chain sizes and software requirements change, so confirm against the source before you order.
Choisissez une taille, payez en crypto, connectez-vous en root. Sans pièce d’identité, sans carte.