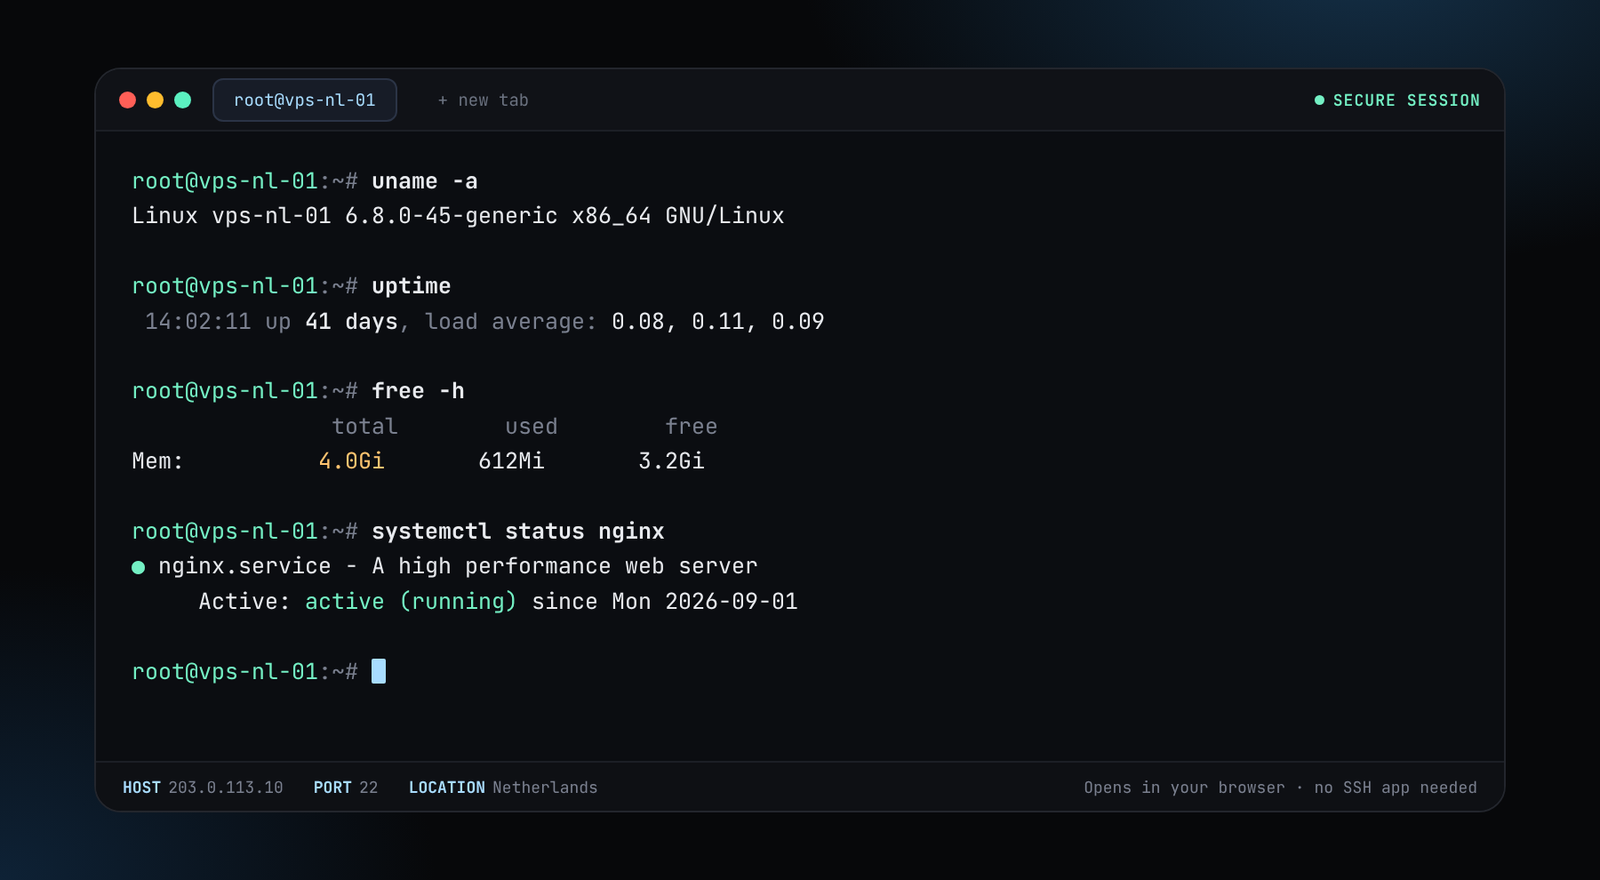
हमारे पास एक नया अपडेट है। अब हम अपना खुद का वेब कंसोल दे रहे हैं। कंसोल खोलें और ssh root@your-server-ip टाइप करें, और अपने किसी भी सर्वर तक सीधे ब्राउज़र से पहुँचें। SSH ऐप की ज़रूरत नहीं।
एजेंट और ऑटोमेशन को ऐसी मशीन चाहिए जो हमेशा चालू रहे, जिसका अपना IP हो और जो आपके लैपटॉप के सोने पर न सोए। होस्टेड मॉडल को कॉल करने वाले एजेंट फ़्रेमवर्क के लिए $8.50 प्रति माह से शुरू होने वाले VPS से शुरुआत करें, या मॉडल खुद चलाने के लिए $109.25 प्रति माह से शुरू होने वाले GPU सर्वर पर जाएँ। पूर्ण root, NVMe स्टोरेज, क्रिप्टो से भुगतान।


VPS की कीमतें रोमानिया में एक महीने की अवधि के लिए हैं। 12 महीने की अवधि पर 50% की छूट मिलती है। GPU की कीमतें मोल्दोवा के लिए हैं।
or $4.25/mo on a 12-month term (−50%)
होस्टेड मॉडल API को कॉल करने वाले एक या दो एजेंट या वर्कफ़्लो, साथ में एक छोटा डेटाबेस।
Configure and orderor $6.50/mo on a 12-month term (−50%)
n8n या Postgres, वेक्टर स्टोर और वेब कार्यों के लिए हेडलेस ब्राउज़र वाला फ़्रेमवर्क।
Configure and orderor $12.75/mo on a 12-month term (−50%)
CPU पर छोटे क्वांटाइज़्ड मॉडल: धीमे लेकिन निजी, आपके एजेंट के बगल में।
Configure and orderor $54.63/mo on a 12-month term (−50%)
मॉडल को उसी सर्वर पर चलाएँ जिस पर उसे इस्तेमाल करने वाला एजेंट है। बड़े GPU GPU पेज पर हैं।
Configure and ordern8n और ऐसे ही टूल: वेबहुक, शेड्यूल और इंटीग्रेशन जो आपके ऑनलाइन होने या न होने पर भी चलते हैं।
LangGraph, CrewAI, AutoGen या आपका अपना Python और Node कोड, जिसे systemd शुरू करता है और विफल होने पर दोबारा चलाता है।
स्क्रेपिंग, मॉनिटरिंग और फ़ॉर्म भरने के कार्यों के लिए Playwright के साथ हेडलेस Chromium। इसे 8 GB RAM दें।
Ollama या vLLM एक ओपन मॉडल चलाते हैं, ताकि प्रॉम्प्ट और दस्तावेज़ आपके किराये के सर्वर पर ही रहें।
ऐसे टूल जिन्हें आपका असिस्टेंट कॉल कर सकता है। विवरण के लिए MCP सर्वर होस्टिंग देखें।
Telegram और Discord बॉट, ट्रेडिंग बॉट और cron जॉब जिन्हें पूरे दिन चलना है।
ज़्यादातर एजेंट खुद बहुत कम काम करते हैं। वे मॉडल को प्रॉम्प्ट भेजते हैं, इंतज़ार करते हैं, फिर कोई टूल कॉल करते हैं। अगर मॉडल किसी प्रोवाइडर के पास चलता है, तो एजेंट सर्वर को बस कुछ गीगाबाइट RAM और एक स्थिर कनेक्शन चाहिए, इसलिए स्टार्टर VPS काफ़ी है।
एजेंट कोड चला सकता है और टूल कॉल कर सकता है, इसलिए उसे किसी भी अविश्वसनीय प्रोसेस की तरह मानें। उसे अपना Linux यूज़र या कंटेनर, खर्च की सीमा वाली मॉडल API कुंजी, और सिर्फ़ उतनी फ़ाइल व नेटवर्क पहुँच दें जितनी ज़रूरी है। वॉलेट की खर्च करने वाली कुंजी या एडमिन पासवर्ड कभी एजेंट के एनवायरनमेंट में न रखें।
अकाउंट बनाएँ, क्रिप्टो से टॉप अप करें और अपना चुना हुआ साइज़ डिप्लॉय करें। कुछ ही मिनटों में root एक्सेस मिल जाता है।
Ubuntu अपडेट करें, एक यूज़र बनाएँ, केवल ज़रूरी पोर्ट खोलें और Docker इंस्टॉल करें।
Docker Compose से n8n शुरू करें, या अपना Python एजेंट systemd सेवा के रूप में चलाएँ।
HTTPS के लिए सामने Caddy लगाएँ और GPU सर्वर पर Ollama इंस्टॉल करें।
कमांड Ubuntu 22.04 या 24.04 और SSH से root लॉगिन मानकर लिखी गई हैं।
ssh root@YOUR_SERVER_IP

apt update && apt -y upgrade
adduser --disabled-password --gecos "" agent

ufw allow OpenSSH
ufw allow 80/tcp
ufw allow 443/tcp
ufw enablecurl -fsSL https://get.docker.com | sh
usermod -aG docker agent
systemctl enable --now dockerयहाँ n8n केवल localhost पर सुनता है। Caddy (चरण 3) उसके सामने HTTPS जोड़ता है। agents.example.com की जगह अपने सर्वर की ओर इशारा करने वाला डोमेन लगाएँ। मौजूदा विकल्पों के लिए n8n होस्टिंग दस्तावेज़ देखें।
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n
    restart: unless-stopped
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_HOST=agents.example.com
      - N8N_PROTOCOL=https
      - WEBHOOK_URL=https://agents.example.com/
      - GENERIC_TIMEZONE=UTC
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
n8n_data:su - agent
cd ~/n8n
docker compose up -d
docker compose logs -f # Ctrl+C to stop watchingएक systemd यूनिट बूट पर एजेंट शुरू करती है और क्रैश होने पर उसे दोबारा चलाती है। सीक्रेट एक ऐसी फ़ाइल में रहते हैं जिसे केवल एजेंट यूज़र पढ़ सकता है।
su - agent
mkdir -p ~/app && cd ~/app
python3 -m venv venv
./venv/bin/pip install requests      # add your framework: langgraph, crewai, autogen...
nano agent.py                       # your agent code
nano .env                           # API_KEY=...   (then: chmod 600 .env)
exit[Unit]
Description=My AI agent
After=network-online.target
Wants=network-online.target
[Service]
User=agent
WorkingDirectory=/home/agent/app
EnvironmentFile=/home/agent/app/.env
ExecStart=/home/agent/app/venv/bin/python agent.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetsystemctl daemon-reload
systemctl enable --now agent
journalctl -u agent -f # Ctrl+C to stop watchingआपका डोमेन सर्वर की ओर इशारा करते ही Caddy खुद प्रमाणपत्र लेता और नवीनीकृत करता है। फिर वेबहुक और वेब इंटरफ़ेस HTTPS पर चलते हैं।
apt -y install caddy
cat > /etc/caddy/Caddyfile <<'EOF'
agents.example.com {
    reverse_proxy 127.0.0.1:5678
}
EOF
systemctl reload caddyOllama localhost पर मॉडल चलाता है, और आपका एजेंट होस्टेड API की जगह उसे कॉल करता है। ऐसा मॉडल चुनें जो GPU मेमोरी में समाए (साइज़िंग टेबल देखें)।
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Say hello in five words.",
  "stream": false
}'# Ollama listens on 127.0.0.1:11434 by default. Leave it that way.
# If an agent on another server needs it, tunnel over SSH instead of opening the port:
ssh -N -L 11434:127.0.0.1:11434 agent@YOUR_SERVER_IPऐसा सर्वर जो आपके AI एजेंट, ऑटोमेशन और बॉट को चौबीसों घंटे चलाता है। आप root एक्सेस वाला VPS या GPU सर्वर किराये पर लेते हैं, अपना एजेंट सॉफ़्टवेयर इंस्टॉल करते हैं और उसे चलता छोड़ देते हैं।
Linux पर चलने वाली कोई भी चीज़: n8n, LangGraph, CrewAI, AutoGen, Flowise, Open WebUI, आपका अपना Python या Node कोड और MCP सर्वर। आपके पास पूर्ण root है, इसलिए Docker भी चलता है।
केवल तब जब आप मॉडल खुद चलाएँ। अगर आपके एजेंट होस्टेड मॉडल API को कॉल करते हैं, तो VPS काफ़ी है। Llama, Mistral या Qwen जैसे लोकल ओपन मॉडल के लिए, या जब प्रॉम्प्ट आपके सर्वर से बाहर नहीं जाने चाहिए, तब GPU सर्वर समझदारी है।
होस्टेड मॉडल को कॉल करने वाले फ़्रेमवर्क के लिए 4 GB, डेटाबेस या हेडलेस ब्राउज़र के साथ 8 GB, और लोकल मॉडल के लिए 32 GB या एक GPU। आप बाद में बड़े प्लान पर जा सकते हैं।
हाँ। Playwright के साथ हेडलेस Chromium VPS पर चलता है। हर खुले पेज पर लगभग 500 MB से 1 GB RAM मानें, और अगर कई एक साथ चलें तो सर्वर को 8 GB दें।
नहीं। आप जनरेट किए गए लॉगिन से अकाउंट बनाते हैं, क्रिप्टो से टॉप अप करते हैं और डिप्लॉय करते हैं। बिना KYC VPS होस्टिंग देखें। आपके एजेंट जो करते हैं उसकी ज़िम्मेदारी हमारी शर्तों के तहत आपकी ही रहती है।
आपके अकाउंट बैलेंस से, जिसे Bitcoin, Monero, Ethereum, Litecoin, Solana, TRON, BNB, USDC या USDT से टॉप अप किया जाता है। लंबी अवधि पर 50% तक की छूट मिलती है। कीमतें देखें।
Checked 20 October 2026. Chain sizes and software requirements change, so confirm against the source before you order.
साइज़ चुनें, क्रिप्टो से भुगतान करें, root के रूप में लॉग इन करें। न ID, न कार्ड।