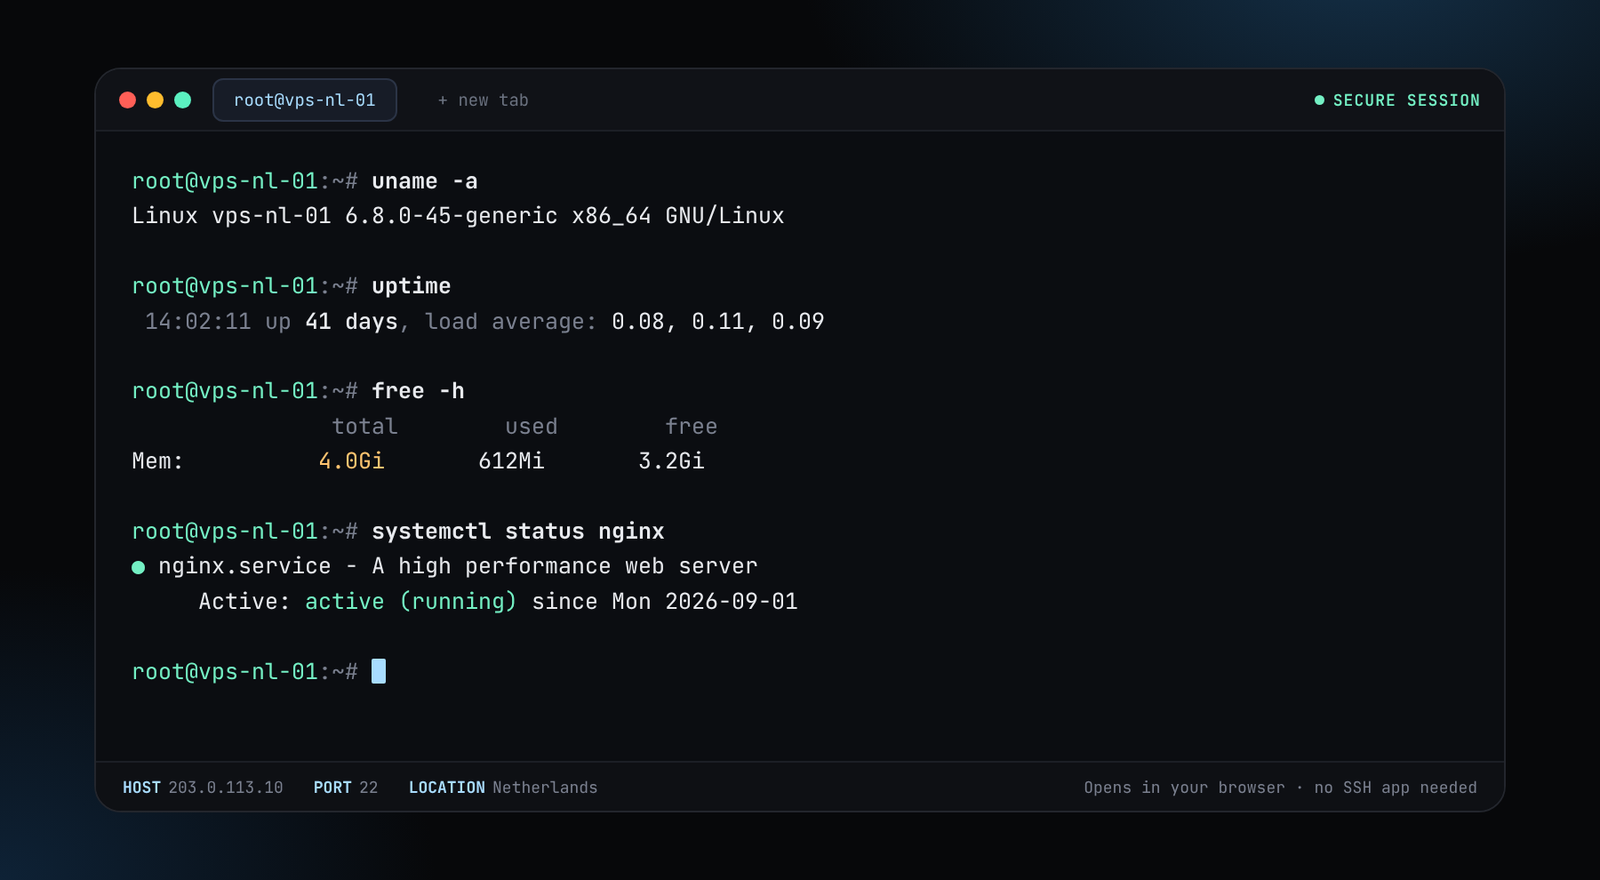
Abbiamo una novità. Ora offriamo la nostra console web. Apri la console e digita ssh root@your-server-ip per raggiungere qualsiasi tuo server direttamente dal browser. Non serve nessuna app SSH.
Agenti e automazioni hanno bisogno di una macchina sempre accesa, con un proprio IP, che non va in sospensione quando lo fa il tuo laptop. Inizia con un VPS da $8.50 al mese per framework di agenti che chiamano modelli ospitati, oppure passa a un server GPU da $109.25 al mese per eseguire il modello da te. Root completo, storage NVMe, pagamento in cripto.


I prezzi dei VPS sono per la Romania con durata di un mese. Una durata di 12 mesi fa risparmiare il 50%. I prezzi delle GPU sono per la Moldavia.
or $4.25/mo on a 12-month term (−50%)
Uno o due agenti o workflow che chiamano API di modelli ospitati, più un piccolo database.
Configure and orderor $6.50/mo on a 12-month term (−50%)
n8n o un framework con Postgres, un archivio di vettori e un browser headless per le attività web.
Configure and orderor $12.75/mo on a 12-month term (−50%)
Piccoli modelli quantizzati su CPU, lenti ma privati, accanto ai tuoi agenti.
Configure and orderor $54.63/mo on a 12-month term (−50%)
Esegui un modello sullo stesso server dell’agente che lo usa. Le GPU più grandi sono nella pagina GPU.
Configure and ordern8n e strumenti simili: webhook, pianificazioni e integrazioni che girano che tu sia online o no.
LangGraph, CrewAI, AutoGen o il tuo codice Python e Node, avviato da systemd e riavviato in caso di errore.
Chromium headless con Playwright per scraping, monitoraggio e compilazione di moduli. Dagli 8 GB di RAM.
Ollama o vLLM che serve un modello aperto, così prompt e documenti restano su un server che affitti.
Strumenti che il tuo assistente può chiamare. Vedi l’hosting di server MCP per i dettagli.
Bot Telegram e Discord, bot di trading e cron job che devono girare tutto il giorno.
La maggior parte degli agenti fa pochissimo lavoro da sola. Invia un prompt a un modello, attende, poi chiama uno strumento. Se il modello gira presso un provider, il server dell’agente ha bisogno solo di qualche gigabyte di RAM e di una connessione stabile, quindi il VPS base è sufficiente.
Un agente può eseguire codice e chiamare strumenti, quindi trattalo come qualsiasi processo non fidato. Dagli un utente Linux o un container dedicato, una chiave API del modello con un limite di spesa e solo l’accesso a file e rete che gli serve. Non mettere mai la chiave di spesa di un wallet o una password di amministratore nell’ambiente di un agente.
Crea un account, ricarica con cripto e distribuisci la dimensione scelta. Ottieni l’accesso root in pochi minuti.
Aggiorna Ubuntu, crea un utente, apri solo le porte necessarie e installa Docker.
Avvia n8n con Docker Compose, oppure esegui il tuo agente Python come servizio systemd.
Metti Caddy davanti per l’HTTPS e installa Ollama su un server GPU.
I comandi presuppongono Ubuntu 22.04 o 24.04 e un accesso root via SSH.
ssh root@YOUR_SERVER_IP

apt update && apt -y upgrade
adduser --disabled-password --gecos "" agent

ufw allow OpenSSH
ufw allow 80/tcp
ufw allow 443/tcp
ufw enablecurl -fsSL https://get.docker.com | sh
usermod -aG docker agent
systemctl enable --now dockerQui n8n ascolta solo su localhost. Caddy (passaggio 3) aggiunge l’HTTPS davanti. Sostituisci agents.example.com con un dominio che punta al tuo server. Consulta la documentazione di hosting di n8n per le opzioni attuali.
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n
    restart: unless-stopped
    ports:
      - "127.0.0.1:5678:5678"
    environment:
      - N8N_HOST=agents.example.com
      - N8N_PROTOCOL=https
      - WEBHOOK_URL=https://agents.example.com/
      - GENERIC_TIMEZONE=UTC
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
n8n_data:su - agent
cd ~/n8n
docker compose up -d
docker compose logs -f # Ctrl+C to stop watchingUn’unità systemd avvia l’agente al boot e lo riavvia se va in crash. I segreti stanno in un file leggibile solo dall’utente dell’agente.
su - agent
mkdir -p ~/app && cd ~/app
python3 -m venv venv
./venv/bin/pip install requests      # add your framework: langgraph, crewai, autogen...
nano agent.py                       # your agent code
nano .env                           # API_KEY=...   (then: chmod 600 .env)
exit[Unit]
Description=My AI agent
After=network-online.target
Wants=network-online.target
[Service]
User=agent
WorkingDirectory=/home/agent/app
EnvironmentFile=/home/agent/app/.env
ExecStart=/home/agent/app/venv/bin/python agent.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetsystemctl daemon-reload
systemctl enable --now agent
journalctl -u agent -f # Ctrl+C to stop watchingCaddy ottiene e rinnova un certificato da solo non appena il tuo dominio punta al server. Webhook e interfacce web funzionano poi in HTTPS.
apt -y install caddy
cat > /etc/caddy/Caddyfile <<'EOF'
agents.example.com {
    reverse_proxy 127.0.0.1:5678
}
EOF
systemctl reload caddyOllama serve un modello su localhost e il tuo agente lo chiama al posto di un’API ospitata. Scegli un modello che stia nella memoria della GPU (vedi la tabella di dimensionamento).
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1:8b",
  "prompt": "Say hello in five words.",
  "stream": false
}'# Ollama listens on 127.0.0.1:11434 by default. Leave it that way.
# If an agent on another server needs it, tunnel over SSH instead of opening the port:
ssh -N -L 11434:127.0.0.1:11434 agent@YOUR_SERVER_IPUn server che esegue i tuoi agenti IA, automazioni e bot ventiquattr’ore su ventiquattro. Affitti un VPS o un server GPU con accesso root, installi il software degli agenti e lo lasci in funzione.
Tutto ciò che gira su Linux: n8n, LangGraph, CrewAI, AutoGen, Flowise, Open WebUI, il tuo codice Python o Node e server MCP. Hai il root completo, quindi funziona anche Docker.
Solo per eseguire il modello da te. Se i tuoi agenti chiamano un’API di modello ospitato, basta un VPS. Un server GPU ha senso per modelli aperti locali come Llama, Mistral o Qwen, o quando i prompt non devono lasciare il tuo server.
4 GB per un framework che chiama modelli ospitati, 8 GB con un database o un browser headless, e 32 GB o una GPU per i modelli locali. Puoi passare a un piano più grande in seguito.
Sì. Chromium headless con Playwright funziona su un VPS. Calcola circa 500 MB–1 GB di RAM per pagina aperta e dai al server 8 GB se ne girano diversi insieme.
No. Crei un account con un login generato, ricarichi in cripto e distribuisci. Vedi l’hosting VPS senza KYC. Resti responsabile di ciò che fanno i tuoi agenti, secondo i nostri termini.
Dal saldo del tuo account, ricaricato con Bitcoin, Monero, Ethereum, Litecoin, Solana, TRON, BNB, USDC o USDT. Le durate più lunghe fanno risparmiare fino al 50%. Vedi i prezzi.
Checked 20 October 2026. Chain sizes and software requirements change, so confirm against the source before you order.
Scegli una dimensione, paga in crypto, accedi come root. Niente documento, niente carta.