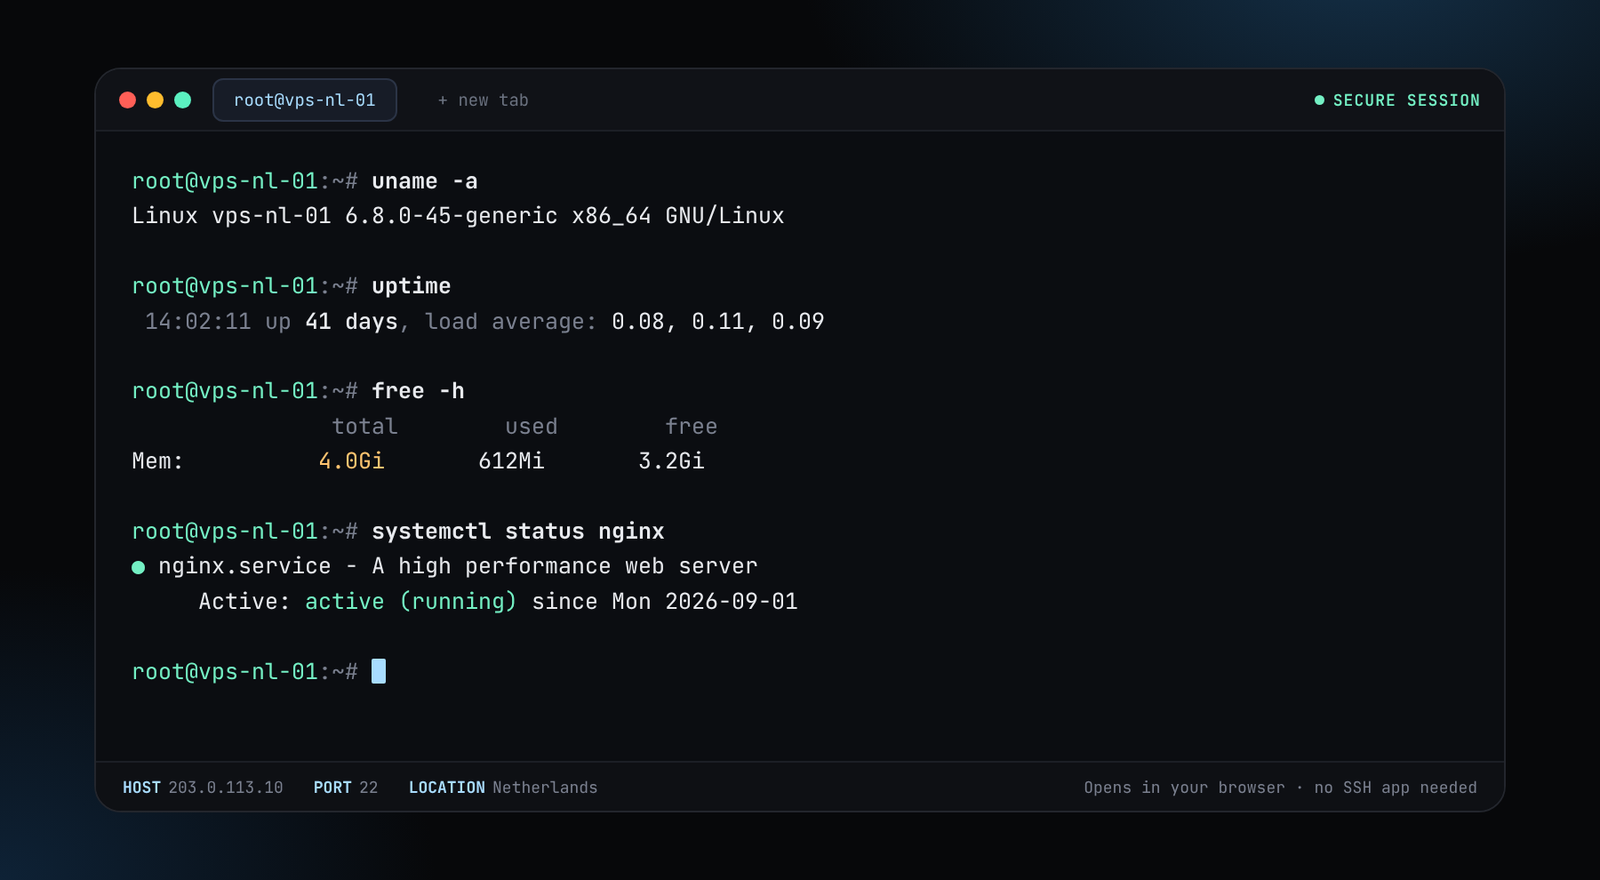
Tenemos una novedad. Ahora ofrecemos nuestra propia consola web. Abre la consola y escribe ssh root@your-server-ip para acceder a cualquiera de tus servidores directamente desde el navegador. Sin necesidad de una app SSH.
Cuando ejecutas tú mismo un modelo de pesos abiertos, tus prompts y documentos van a un servidor que alquilas, no a una API de terceros. La pregunta que lo decide todo es si el modelo cabe en la memoria de la GPU. Esta página te da la aritmética y el servidor adecuado, con precios reales.


Regla práctica: pesos = parámetros × bytes por peso, más un 20 % aproximado para memoria de trabajo. Las necesidades reales varían con la longitud del contexto, el tamaño del lote y el software.
| Modelo y precisión | Memoria estimada | 1x RTX 4090 (24 GB) | 1x RTX 5090 (32 GB) | 1x H100 (80 GB) | 2x H100 (160 GB) |
|---|---|---|---|---|---|
| 8B parámetros, 16 bits | ~20 GB | cabe | cabe | cabe | cabe |
| 8B parámetros, 8 bits | ~10 GB | cabe | cabe | cabe | cabe |
| 8B parámetros, 4 bits | ~5 GB | cabe | cabe | cabe | cabe |
| 32B parámetros, 16 bits | ~77 GB | no | no | cabe | cabe |
| 32B parámetros, 8 bits | ~39 GB | no | no | cabe | cabe |
| 32B parámetros, 4 bits | ~20 GB | cabe | cabe | cabe | cabe |
| 70B parámetros, 16 bits | ~168 GB | no | no | no | no |
| 70B parámetros, 8 bits | ~84 GB | no | no | no | cabe |
| 70B parámetros, 4 bits | ~42 GB | no | no | cabe | cabe |
| 120B parámetros, 16 bits | ~288 GB | no | no | no | no |
| 120B parámetros, 8 bits | ~144 GB | no | no | no | cabe |
| 120B parámetros, 4 bits | ~72 GB | no | no | cabe | cabe |
Son estimaciones para planificar, no benchmarks. Un modelo que apenas cabe deja poco espacio para prompts largos, así que deja margen. Los modelos cuantizados pierden algo de calidad; prueba el tuyo.
Los precios cambian según la ubicación que elija. Un plazo más largo tiene hasta un 50 % de descuento.
or $54.63/mo on a 12-month term (−50%)
Cabe en modelos pequeños y medianos, y 32B a 4 bits.
Configure and orderor $87.88/mo on a 12-month term (−50%)
Más margen para el contexto y modelos cuantizados más grandes.
Configure and orderor $375.25/mo on a 12-month term (−50%)
Un modelo de 70B a 4 bits, o a 8 bits para tamaños medianos.
Configure and orderor $707.75/mo on a 12-month term (−50%)
Modelos muy grandes y modelos medianos a 16 bits.
Configure and orderElijas lo que elijas, no expongas la API del modelo a internet sin autenticación. Nuestra guía está en ejecutar LLM en un servidor GPU.
Tus prompts se quedan en un servidor que alquilas y nadie más comparte la GPU. No se envían a un proveedor de modelos. El servidor sigue alojado por nosotros, no monitorizamos ni registramos lo que hay dentro de tus servidores, y las reglas de nuestros términos se aplican a todo lo que ejecutes, incluido lo que generes y publiques. Eres responsable de cumplir la licencia del modelo que descargues.
Sí, si cumples la licencia del modelo. Elige un servidor cuya memoria de GPU contenga el modelo con algo de margen, instala una herramienta de servicio como Ollama o vLLM y protege la API.
Aproximadamente 35 GB de pesos a 4 bits, 70 GB a 8 bits y 140 GB a 16 bits, más un 20 % para memoria de trabajo. Según esa estimación, un modelo de 70B a 4 bits necesita una H100 de 80 GB, no una tarjeta de 24 o 32 GB.
El servidor con RTX 4090 los admite con cualquier precisión de la tabla, y el más barato cuesta $109.25 al mes. Los modelos más grandes necesitan más memoria.
No. Significa que eliges y ejecutas el modelo en tu propio servidor. Lo que generas y publicas sigue cubierto por la ley y por nuestros términos.
No. Genera un inicio de sesión y paga en cripto. Consulta servidores GPU sin KYC.
Mensualmente desde tu saldo prepago, con hasta un 50 % de descuento en plazos más largos. Consulta los precios.
Elige una GPU, paga en cripto, inicia sesión como root. Sin ID, sin tarjeta.