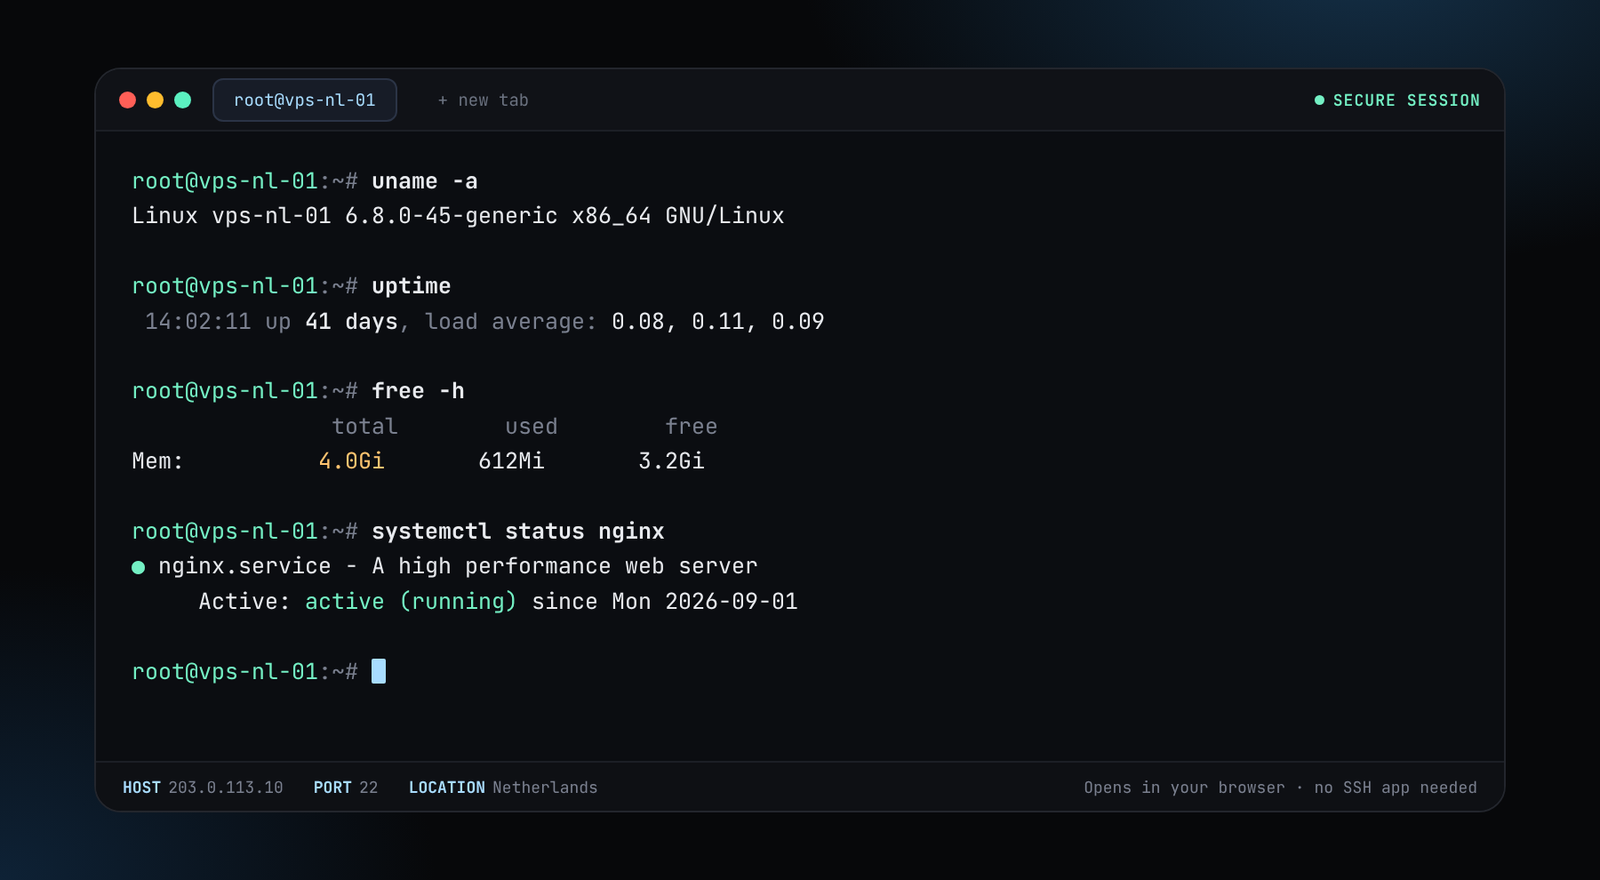
Chúng tôi vừa có bản cập nhật mới. Giờ đây chúng tôi cung cấp Web Console riêng. Mở console và gõ ssh root@your-server-ip để truy cập bất kỳ máy chủ nào của bạn ngay trên trình duyệt. Không cần ứng dụng SSH.
Khi bạn tự chạy một mô hình open-weight, prompt và tài liệu của bạn đi tới một máy chủ bạn thuê, không phải một API bên thứ ba. Câu hỏi quyết định mọi thứ là mô hình có vừa bộ nhớ GPU hay không. Trang này cho bạn phép tính và máy chủ phù hợp, kèm giá thật.


Quy tắc ngón tay cái: trọng số = tham số × byte mỗi trọng số, cộng khoảng 20% cho bộ nhớ làm việc. Nhu cầu thực tế thay đổi theo độ dài ngữ cảnh, kích thước batch và phần mềm.
| Mô hình và độ chính xác | Bộ nhớ ước tính | 1x RTX 4090 (24 GB) | 1x RTX 5090 (32 GB) | 1x H100 (80 GB) | 2x H100 (160 GB) |
|---|---|---|---|---|---|
| 8B tham số, 16-bit | ~20 GB | vừa | vừa | vừa | vừa |
| 8B tham số, 8-bit | ~10 GB | vừa | vừa | vừa | vừa |
| 8B tham số, 4-bit | ~5 GB | vừa | vừa | vừa | vừa |
| 32B tham số, 16-bit | ~77 GB | no | no | vừa | vừa |
| 32B tham số, 8-bit | ~39 GB | no | no | vừa | vừa |
| 32B tham số, 4-bit | ~20 GB | vừa | vừa | vừa | vừa |
| 70B tham số, 16-bit | ~168 GB | no | no | no | no |
| 70B tham số, 8-bit | ~84 GB | no | no | no | vừa |
| 70B tham số, 4-bit | ~42 GB | no | no | vừa | vừa |
| 120B tham số, 16-bit | ~288 GB | no | no | no | no |
| 120B tham số, 8-bit | ~144 GB | no | no | no | vừa |
| 120B tham số, 4-bit | ~72 GB | no | no | vừa | vừa |
Đây là ước tính để lên kế hoạch, không phải benchmark. Một mô hình vừa khít chừa rất ít chỗ cho prompt dài, nên hãy để dư. Mô hình lượng tử hóa mất một phần chất lượng; hãy kiểm tra mô hình của bạn.
Giá thay đổi theo vị trí bạn chọn. Kỳ hạn dài hơn được giảm tới 50%.
or $54.63/mo on a 12-month term (−50%)
Vừa mô hình nhỏ và trung bình, và 32B ở 4-bit.
Configure and orderor $87.88/mo on a 12-month term (−50%)
Dư địa hơn cho ngữ cảnh và các mô hình lượng tử hóa lớn hơn.
Configure and orderor $375.25/mo on a 12-month term (−50%)
Mô hình 70B ở 4-bit, hoặc 8-bit cho cỡ trung.
Configure and orderor $707.75/mo on a 12-month term (−50%)
Mô hình rất lớn và mô hình cỡ trung ở 16-bit.
Configure and orderDù chọn gì, đừng mở API của mô hình ra internet mà không có xác thực. Hướng dẫn của chúng tôi nằm ở chạy LLM trên máy chủ GPU.
Prompt của bạn ở lại trên một máy chủ bạn thuê và không ai khác dùng chung GPU. Chúng không được gửi tới nhà cung cấp mô hình. Máy chủ vẫn do chúng tôi lưu trữ, chúng tôi không giám sát hay ghi nhật ký bên trong máy chủ của bạn, và các quy tắc trong điều khoản của chúng tôi áp dụng cho mọi thứ bạn chạy, kể cả những gì bạn tạo ra và đăng tải. Bạn chịu trách nhiệm tuân thủ giấy phép của mô hình bạn tải về.
Có, nếu bạn tuân thủ giấy phép của mô hình. Chọn máy chủ có bộ nhớ GPU chứa vừa mô hình với chút dư địa, cài một công cụ phục vụ như Ollama hoặc vLLM và bảo mật API.
Khoảng 35 GB trọng số ở 4-bit, 70 GB ở 8-bit và 140 GB ở 16-bit, cộng khoảng 20% cho bộ nhớ làm việc. Theo ước tính đó, mô hình 70B 4-bit cần H100 80 GB, không phải thẻ 24 hay 32 GB.
Máy chủ RTX 4090 chứa được chúng ở mọi độ chính xác trong bảng, và cái rẻ nhất là $109.25 mỗi tháng. Mô hình lớn hơn cần nhiều bộ nhớ hơn.
Không. Nó có nghĩa là bạn chọn và chạy mô hình trên máy chủ của riêng mình. Những gì bạn tạo ra và đăng tải vẫn thuộc phạm vi luật pháp và điều khoản của chúng tôi.
Không. Hãy tạo một đăng nhập và thanh toán bằng tiền mã hóa. Xem máy chủ GPU không KYC.
Hằng tháng từ số dư trả trước của bạn, giảm tới 50% cho kỳ hạn dài hơn. Xem bảng giá.
Chọn một GPU, thanh toán bằng tiền mã hóa, đăng nhập với quyền root. Không ID, không thẻ.